

في هذا المقال
كيف يفهم الحاسوب اللغات البشرية؟
لما الإنسان يتكلم مع شخص تاني، الموضوع بالنسبة له بيكون طبيعي جدًا. بنسمع الجملة، نفهم الكلمات، نربطها بالسياق، ونستنتج المقصود حتى لو الكلام فيه أخطاء أو لهجة عامية أو كلمة ناقصة.
لكن بالنسبة للحاسوب، الموضوع مختلف تمامًا.
لو قلت للكمبيوتر:
«"أنا رايح الجامعة بكرة."»
فالكمبيوتر في البداية مش بيسمع "معنى" الجملة زي الإنسان. هو بيتعامل مع إشارة صوتية لو الكلام منطوق، أو مجموعة من الرموز والحروف لو الكلام مكتوب. وبالتالي السؤال المهم هنا هو:
إزاي الحاسوب ينتقل من مجرد حروف أو أصوات إلى معنى يمكنه التعامل معه؟
هنا يظهر مجال معالجة اللغات الطبيعية Natural Language Processing أو NLP، وهو أحد فروع الذكاء الاصطناعي الذي يهتم بجعل الحاسوب قادرًا على التعامل مع اللغة البشرية، سواء كانت نصوصًا مكتوبة أو كلامًا منطوقًا.
ومع تطور الذكاء الاصطناعي، المجال بقى أوسع بكثير من مجرد التعرف على الكلمات. الكمبيوتر أصبح قادرًا على الترجمة، والتلخيص، والإجابة عن الأسئلة، وتحليل المشاعر، واستخراج المعلومات، وحتى إجراء محادثات طويلة. لكن وراء كل ده توجد طبقات كثيرة من المعالجة.
---
الكمبيوتر لا يفهم اللغة بالطريقة التي يفهمها الإنسان
أول حاجة لازم نفهمها إن كلمة "يفهم" هنا مش معناها إن الكمبيوتر عنده فهم بشري للغة.
الإنسان لما يسمع:
«"الولد كسر الكوباية."»
فهو يكوّن تصورًا ذهنيًا عن ولد وكوباية وفعل حدث بينهما.
أما الكمبيوتر فيحتاج إلى تحويل الكلام إلى تمثيل رياضي يمكن للخوارزميات التعامل معه.
يعني الجملة بالنسبة للآلة لازم تتحول من:
الولد كسر الكوباية
إلى تمثيلات رقمية يمكن للنموذج معالجتها.
وهنا تبدأ رحلة Natural Language Processing.
---
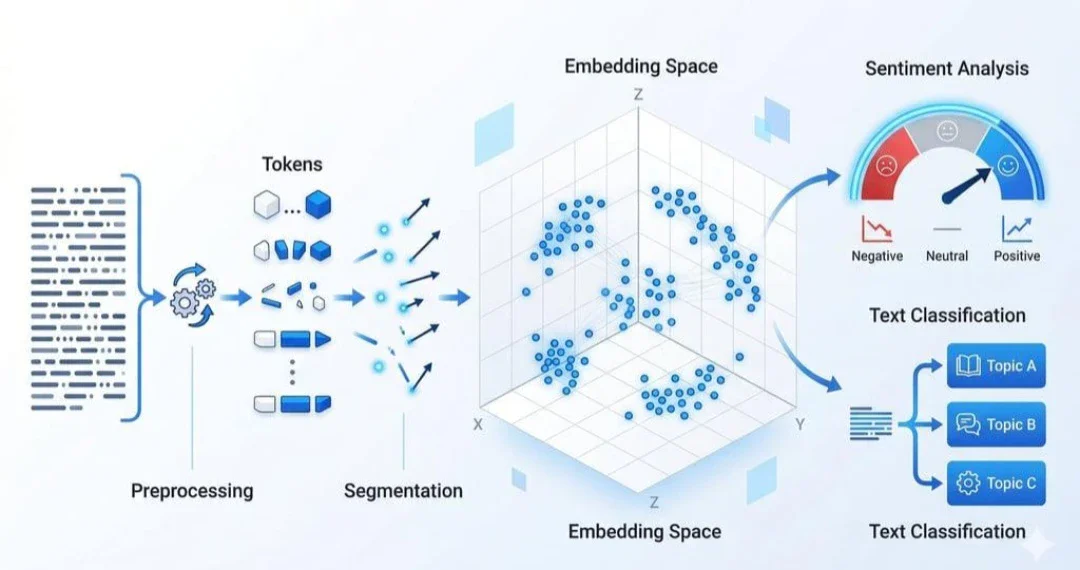
أول خطوة: تقسيم النص
لو عندنا الجملة:
الولد كسر الكوباية.
فواحدة من العمليات الأساسية هي تقسيم النص إلى وحدات.
في اللغة الإنجليزية، مثلًا، يمكن تقسيم:
The boy broke the cup.
إلى:
The
boy
broke
the
cup
والوحدات دي تسمى Tokens.
لكن الموضوع مش بهذه البساطة دائمًا، خصوصًا في اللغة العربية.
اللغة العربية فيها خصائص تجعل المعالجة أكثر تعقيدًا، مثل اتصال حروف الجر والعطف بالكلمات، واختلاف أشكال الكلمات، والتشكيل، والتصريف.
مثلًا:
وبالمدرسة
قد تحتاج إلى تحليلها إلى مكونات لغوية مختلفة حسب المهمة.
إذن أول تحدي أمام الكمبيوتر هو معرفة: إيه الوحدات الموجودة أصلًا في النص؟
---
تحليل الكلمات والتصريف
بعد تقسيم النص، يمكن للنظام تحليل الكلمات من الناحية الصرفية.
مثلًا:
كتب
كاتب
مكتوب
يكتب
اكتب
كلها مرتبطة بجذر ومعانٍ وصيغ صرفية مختلفة.
وفي العربية تحديدًا، Morphological Analysis مهم جدًا لأن الكلمة يمكن أن تحمل معلومات كثيرة في شكلها.
مثلًا كلمة:
وسنكتبها
قد تحتوي على أكثر من معلومة:
و + سـ + نكتب + ها
بحسب التحليل والسياق.
النظام يحتاج إلى اكتشاف هذه العلاقات حتى يستطيع التعامل مع الكلمة بطريقة صحيحة.
---
Syntax: كيف ترتبط الكلمات ببعضها؟
بعد معرفة الكلمات، نحتاج إلى معرفة العلاقة بينها.
وده هو مجال Syntactic Analysis.
خذ الجملة:
الطالب قرأ الكتاب.
النظام يحتاج إلى معرفة أن:
الطالب
فاعل، وأن:
قرأ
فعل، وأن:
الكتاب
مفعول به.
إذن اللغة ليست مجرد مجموعة كلمات منفصلة.
المعنى يعتمد على العلاقات بين الكلمات.
وهنا يمكن استخدام تقنيات مثل Dependency Parsing لبناء شبكة من العلاقات بين الكلمات.
مثلًا بشكل مبسط:
قرأ
├── الطالب
└── الكتاب
وبالتالي يبدأ الكمبيوتر في تكوين تمثيل لبنية الجملة.
---
Semantics: طيب إيه معنى الكلام؟
وهنا نصل إلى مستوى أصعب، وهو Semantic Analysis.
لو قلنا:
الولد أكل التفاحة.
المعنى واضح نسبيًا.
لكن ماذا لو قلنا:
عينه كانت زرقاء.
هل كلمة "عين" هنا تشير إلى عضو في جسم الإنسان أم إلى شيء آخر؟
السياق هو الذي يحدد المعنى.
وهنا تظهر مشكلة مهمة في اللغة البشرية، وهي Ambiguity أو الغموض.
الكلمة الواحدة قد يكون لها أكثر من معنى، والجملة الواحدة قد تحتمل أكثر من تفسير.
الإنسان يستطيع غالبًا تحديد المعنى الصحيح باستخدام السياق والمعرفة السابقة.
أما الحاسوب فيحتاج إلى نماذج قادرة على الاستفادة من السياق.
---
Context: الكلمة لا تعيش وحدها
من أهم التطورات في NLP أن النماذج الحديثة لم تعد تتعامل مع الكلمة باعتبارها وحدة منفصلة تمامًا.
خذ مثلًا كلمة:
bank
في الإنجليزية.
قد تعني بنكًا ماليًا، وقد تشير إلى ضفة نهر.
المعنى الصحيح يعتمد على الكلمات المحيطة.
لذلك أصبحت نماذج اللغة الحديثة تعتمد على Contextual Representations.
أي أن تمثيل الكلمة يمكن أن يتغير حسب السياق الذي ظهرت فيه.
وده كان تحولًا كبيرًا في مجال معالجة اللغة.
---
تحويل الكلمات إلى أرقام
الحاسوب لا يستطيع إدخال الكلمات مباشرة إلى العمليات الرياضية.
لازم الكلمات تتحول إلى تمثيلات رقمية.
في الأنظمة القديمة كان يمكن استخدام تمثيلات بسيطة مثل:
One-Hot Encoding
حيث كل كلمة يتم تمثيلها بمتجه يحتوي على أرقام.
لكن المشكلة إن هذه الطريقة لا تمثل التشابه بين الكلمات.
مثلًا:
ملك
رئيس
وزير
قد تكون بينها علاقات دلالية معينة، بينما الـOne-Hot Representation لا يعبر عنها.
وهنا ظهرت Word Embeddings.
---
Word Embeddings
الفكرة الأساسية في الـEmbeddings هي تمثيل الكلمات كمتجهات في فضاء رياضي.
مثلًا:
كلمة → Vector
فتصبح الكلمة ممثلة بمجموعة من الأرقام.
الكلمات التي تظهر في سياقات متشابهة يمكن أن تصبح قريبة من بعضها في هذا الفضاء.
وبالتالي يمكن للنظام اكتشاف بعض العلاقات الدلالية والإحصائية بين الكلمات.
وهنا بدأت اللغة تتحول إلى شيء يمكن التعامل معه باستخدام Linear Algebra والرياضيات.
---
من Embeddings إلى Transformers
مع تطور المجال، ظهرت بنية مهمة جدًا تسمى Transformer.
الـTransformer غيّر طريقة التعامل مع اللغة بشكل كبير.
ومن أهم الأفكار الموجودة فيه Attention Mechanism.
الفكرة ببساطة إن النموذج أثناء معالجة كلمة معينة يستطيع إعطاء أوزان مختلفة للكلمات الأخرى الموجودة في السياق.
مثلًا في:
الولد ذهب إلى المدرسة لأنه كان متأخرًا.
النموذج يحتاج إلى ربط الضمير والسياق بما يشير إليه.
الـAttention يسمح للنموذج بالتعامل مع العلاقات بين أجزاء مختلفة من النص.
وده أحد الأسباب الرئيسية وراء نجاح نماذج اللغة الحديثة.
---
كيف يتعلم نموذج اللغة؟
النموذج لا يولد وهو يعرف اللغة.
يتم تدريبه على كميات ضخمة من النصوص.
ومن المهام الأساسية التي يمكن استخدامها في التدريب توقع أجزاء ناقصة أو تالية من النص.
مثلًا:
أنا ذاهب إلى …
النموذج يحاول تقدير الكلمات المحتملة التي يمكن أن تأتي بعد ذلك بناءً على ما تعلمه من البيانات.
لكن أثناء التدريب، النموذج لا يحفظ فقط مجموعة جمل جاهزة بالضرورة، بل يتعلم أنماطًا إحصائية وعلاقات بين الرموز والسياقات.
ومن خلال ملايين أو مليارات الأمثلة، تتكون داخل النموذج تمثيلات معقدة للغة.
---
Tokenization
قبل إدخال النص إلى نموذج اللغة، يتم عادة تقسيمه إلى Tokens باستخدام نظام يسمى Tokenizer.
والـToken مش لازم يكون كلمة كاملة.
قد يكون:
كلمة
أو جزءًا من كلمة، أو مجموعة حروف، حسب تصميم الـTokenizer.
وده مهم جدًا خصوصًا في اللغات التي تحتوي على تصريفات كثيرة، مثل العربية.
النص يتحول إلى Tokens، ثم تتحول الـTokens إلى أرقام أو IDs، وبعدها يتم تحويلها إلى تمثيلات متجهية تدخل إلى النموذج.
يعني الرحلة ممكن تكون:
نص بشري
↓
Tokenization
↓
Token IDs
↓
Embeddings
↓
Transformer
↓
Contextual Representation
↓
Output
---
طيب لو الكلام صوت؟
لو الإنسان بيتكلم بدل ما يكتب، فالموضوع يبدأ من الصوت نفسه.
الصوت عبارة عن إشارة Signal.
النظام يحتاج أولًا إلى معالجة الإشارة الصوتية وتحويلها إلى تمثيل مناسب.
ثم يأتي دور Automatic Speech Recognition أو ASR لتحويل الكلام المنطوق إلى نص.
مثلًا:
صوت الإنسان
↓
Audio Signal
↓
Speech Processing
↓
Speech Recognition
↓
Text
↓
NLP
يعني لو قلت:
«"افتح الباب."»
فالنظام قد يحول الصوت أولًا إلى النص:
افتح الباب
وبعدها تبدأ مرحلة فهم اللغة.
---
طيب إزاي الكمبيوتر يترجم؟
الترجمة الآلية Machine Translation مثال واضح جدًا على استخدام NLP.
لو عندنا:
The student reads the book.
النظام لا يحتاج فقط إلى استبدال كل كلمة بكلمة عربية.
لو فعل ذلك حرفيًا، ممكن ينتج جملة غريبة جدًا.
المطلوب هو فهم العلاقة بين الكلمات والسياق ثم إنتاج جملة في اللغة الأخرى تحافظ قدر الإمكان على المعنى.
لذلك أصبحت النماذج الحديثة تعتمد على بنى مثل Encoder-Decoder وTransformers.
---
Sentiment Analysis
من التطبيقات المشهورة أيضًا تحليل المشاعر Sentiment Analysis.
مثلًا:
المنتج ممتاز جدًا.
النظام يستطيع تصنيف النص باعتباره إيجابيًا.
بينما:
الخدمة سيئة جدًا.
قد يصنفه باعتباره سلبيًا.
وهذا يستخدم في تحليل آراء العملاء، ومراجعات المنتجات، وتحليل المحتوى وغيرها.
لكن المشاعر البشرية ليست دائمًا واضحة.
مثلًا:
يا سلام، خدمة عظيمة فعلًا!
قد تكون جملة مدح، وقد تكون سخرية.
وهنا يعود التحدي نفسه:
السياق.
---
هل الكمبيوتر يفهم فعلًا؟
هنا لازم نفرق بين القدرة على معالجة اللغة وبين الفهم البشري الكامل.
النموذج يستطيع اكتشاف أنماط معقدة جدًا في اللغة، وربط الكلمات بالسياقات، وتوليد نصوص متماسكة، والإجابة عن أسئلة، وترجمة النصوص، وتلخيصها.
لكن ده لا يعني بالضرورة أن لديه تجربة بشرية للمعنى بنفس الطريقة التي يمتلكها الإنسان.
الإنسان عنده خبرات حسية واجتماعية وجسدية وثقافية واسعة.
أما النموذج فيتعلم من البيانات التي تدرب عليها، ويستخدم تمثيلات رياضية وحسابات احتمالية لإنتاج مخرجات مناسبة للسياق.
وده يجعل السؤال "هل يفهم؟" سؤالًا فلسفيًا وعلميًا في نفس الوقت، وليس مجرد سؤال برمجي.
---
مستقبل معالجة اللغات الطبيعية
المجال بيتطور بسرعة كبيرة.
النماذج الحديثة أصبحت تجمع بين النص والصوت والصورة والفيديو، وظهرت أنظمة Multimodal AI قادرة على التعامل مع أكثر من نوع من البيانات.
وهنا ممكن يكون عندك نظام يستقبل:
صوت
+
نص
+
صورة
+
فيديو
ويحاول تكوين تمثيل مشترك للمعلومات.
وده يفتح تطبيقات واسعة في التعليم، والطب، والروبوتات، وخدمة العملاء، والبحث العلمي، والمساعدات الذكية.
وفي الروبوتات مثلًا، يمكن أن يقول الإنسان:
«"روح للغرفة اللي على اليمين وخد الصندوق الأحمر."»
النظام يحتاج إلى تحويل اللغة إلى تمثيل قابل للتنفيذ، وربط الكلمات بالبيئة، ثم تحويل الأمر إلى Planning وControl Actions.
هنا تبدأ NLP في الارتباط بمجالات أخرى مثل Computer Vision وRobotics وControl Systems.
---
الخلاصة
معالجة اللغات الطبيعية هي المجال الذي يحاول جعل الحاسوب قادرًا على التعامل مع اللغة البشرية من خلال الخوارزميات والنماذج الرياضية.
والرحلة تبدأ من النص أو الصوت، ثم تمر بمراحل مثل Tokenization، Morphological Analysis، Syntactic Analysis، Semantic Analysis، Context Modeling، وبعدها تستخدم تمثيلات رياضية مثل Embeddings وبنى حديثة مثل Transformers.
فلو الإنسان قال:
الولد كسر الكوباية.
الحاسوب لا يستقبل "المعنى" مباشرة. بل يبدأ بتحويل الكلام إلى رموز، ثم إلى تمثيلات رقمية، ثم يحلل العلاقات بين هذه الرموز ويستخدم السياق لإنتاج تمثيل يساعده على تنفيذ المهمة المطلوبة.
إذن، عندما نتكلم عن أن الحاسوب "يفهم اللغة"، فالمقصود عمليًا أن النظام يستطيع معالجة الرموز اللغوية، واكتشاف الأنماط والعلاقات، وبناء تمثيلات رياضية للسياق، ثم استخدام هذه التمثيلات لإنتاج استجابة أو قرار.
ومن هنا أصبحت اللغة البشرية واحدة من أهم ساحات الذكاء الاصطناعي، لأن الهدف النهائي ليس مجرد جعل الكمبيوتر يقرأ الكلمات، وإنما جعله يتعامل مع اللغة باعتبارها وسيلة للتواصل مع العالم والإنسان.
وفي النهاية، الإنسان يقول جملة قصيرة، بينما خلف هذه الجملة توجد Tokenization وEmbeddings وAttention وTransformers وحسابات رياضية ضخمة. الإنسان يتكلم في ثانيتين، والكمبيوتر يبدأ رحلة حسابية طويلة حتى لا يجيبك بشيء عن البطاطس عندما كنت تتكلم عن البرمجة.




النقاش
التعليقات (0)
فكرة تضيفها، أو سؤال يفتح حوارًا.
الرجاء تسجيل الدخول لتتمكن من التعليق