

في هذا المقال
المترجمات وكيف بتتصمم لغات البرمجة
لما المبرمج يكتب برنامج بلغة زي C أو C++ أو Rust أو Java، الكود اللي هو بيكتبه مش هو اللغة اللي المعالج بيفهمها بشكل مباشر. المعالج في النهاية بيتعامل مع مجموعة تعليمات منخفضة المستوى مرتبطة بالـ Instruction Set Architecture بتاعته، زي x86 أو ARM أو RISC-V.
يعني لما تكتب:
int x = 10;
int y = 20;
int z = x + y;
المعالج مش بيشوف الكلام ده ويفهم إن "x" متغير وإن "+" معناها جمع. هو في النهاية محتاج تعليمات Machine Code مناسبة لمعمارية المعالج.
وهنا بيظهر دور Compiler أو المترجم.
المترجم هو البرنامج اللي بياخد الـ Source Code اللي كتبه المبرمج، يحلله ويفهم تركيبه ومعناه، وبعد كده يحوله إلى تمثيل تاني قابل للتنفيذ، سواء كان Machine Code أو Assembly أو Intermediate Representation أو غيره حسب تصميم اللغة والمترجم.
لكن الموضوع أكبر من مجرد "تحويل كود إلى كود". تصميم المترجمات مرتبط أصلًا بتصميم لغات البرمجة نفسها.
يعني إيه Compiler؟
ببساطة، الـCompiler هو برنامج بيترجم برنامج مكتوب بلغة معينة إلى لغة أخرى.
اللغة الأولى بنسميها Source Language، واللغة الناتجة بنسميها Target Language.
مثلًا، ممكن يكون عندنا برنامج مكتوب بلغة C، والمترجم يحوله إلى Assembly، وبعدها يتم تحويل الـAssembly إلى Machine Code.
لكن المترجم مش بيشتغل بطريقة قاموس:
«الكلمة دي تتحول للكلمة دي، والقوس يتحول لحاجة تانية.»
لو كان الموضوع بالبساطة دي، كان زمان أي طالب يعمل Compiler في إجازة نص السنة، ونروح كلنا نشتغل ونسيب البشرية ترتاح.
المترجم في الحقيقة بيعمل مجموعة مراحل معقدة من التحليل والتحويل.
أول مرحلة: Lexical Analysis
أول حاجة بتحصل هي Lexical Analysis أو التحليل المعجمي.
المترجم بياخد الكود كنص، ويبدأ يقسمه إلى وحدات صغيرة اسمها Tokens.
لو عندنا مثلًا:
x = a + 10;
المترجم يقدر يشوفها بالشكل ده:
x → Identifier
= → Assignment Operator
a → Identifier
+ → Arithmetic Operator
10 → Number
; → Statement Terminator
وهنا المترجم لازم يكون عارف قواعد اللغة.
مثلًا: إيه الكلمات المحجوزة؟ إيه شكل أسماء المتغيرات؟ إزاي بنكتب الأرقام؟ إزاي بنكتب String؟ التعليقات بتبدأ وتنتهي فين؟ وإيه الرموز اللي تعتبر Operators؟
الجزء ده غالبًا بيتعامل مع Regular Expressions وFinite Automata، ودي واحدة من النقاط اللي بتربط بين Compiler Design وبين Theory of Computation.
بعد كده: Syntax Analysis
بعد ما المترجم يعرف الـTokens، لازم يتأكد إن ترتيبها صحيح حسب قواعد اللغة.
ودي مرحلة Syntax Analysis أو Parsing.
مثلًا:
x = a + b;
جملة صحيحة من ناحية الـSyntax.
لكن لو كتبنا تركيب عشوائي زي:
x + = ;
فالمترجم هيكتشف إن التركيب ده مش متوافق مع الـGrammar الخاصة باللغة.
وهنا بيظهر مفهوم مهم جدًا اسمه Grammar.
الـGrammar هي مجموعة القواعد اللي بتحدد إزاي العناصر المختلفة في اللغة ممكن تتجمع مع بعض لتكوين برنامج صحيح.
ومن أشهر طرق بناء الـParsers:
- Recursive Descent
- LL Parsing
- LR Parsing
- LALR Parsing
والـParser بيحول الـTokens إلى بنية منظمة تمثل البرنامج.
Abstract Syntax Tree
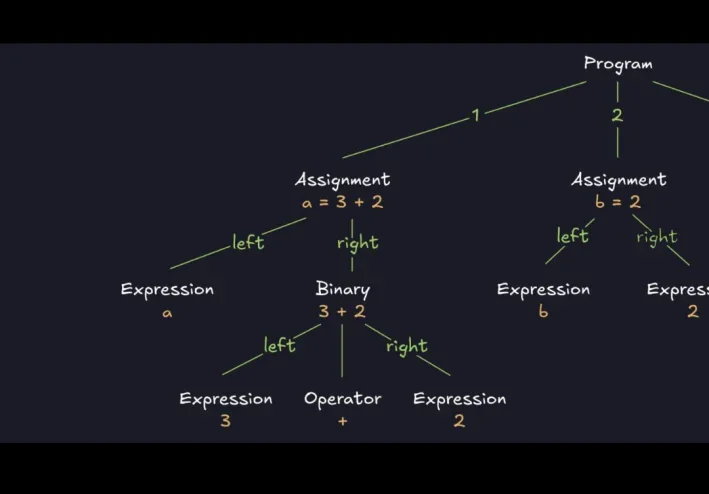
بعد الـParsing، المترجم غالبًا بيبني حاجة اسمها Abstract Syntax Tree أو AST.
ودي شجرة بتمثل تركيب البرنامج
المترجم لازم يفهم إن الضرب بيتنفذ قبل الجمع.
مثال
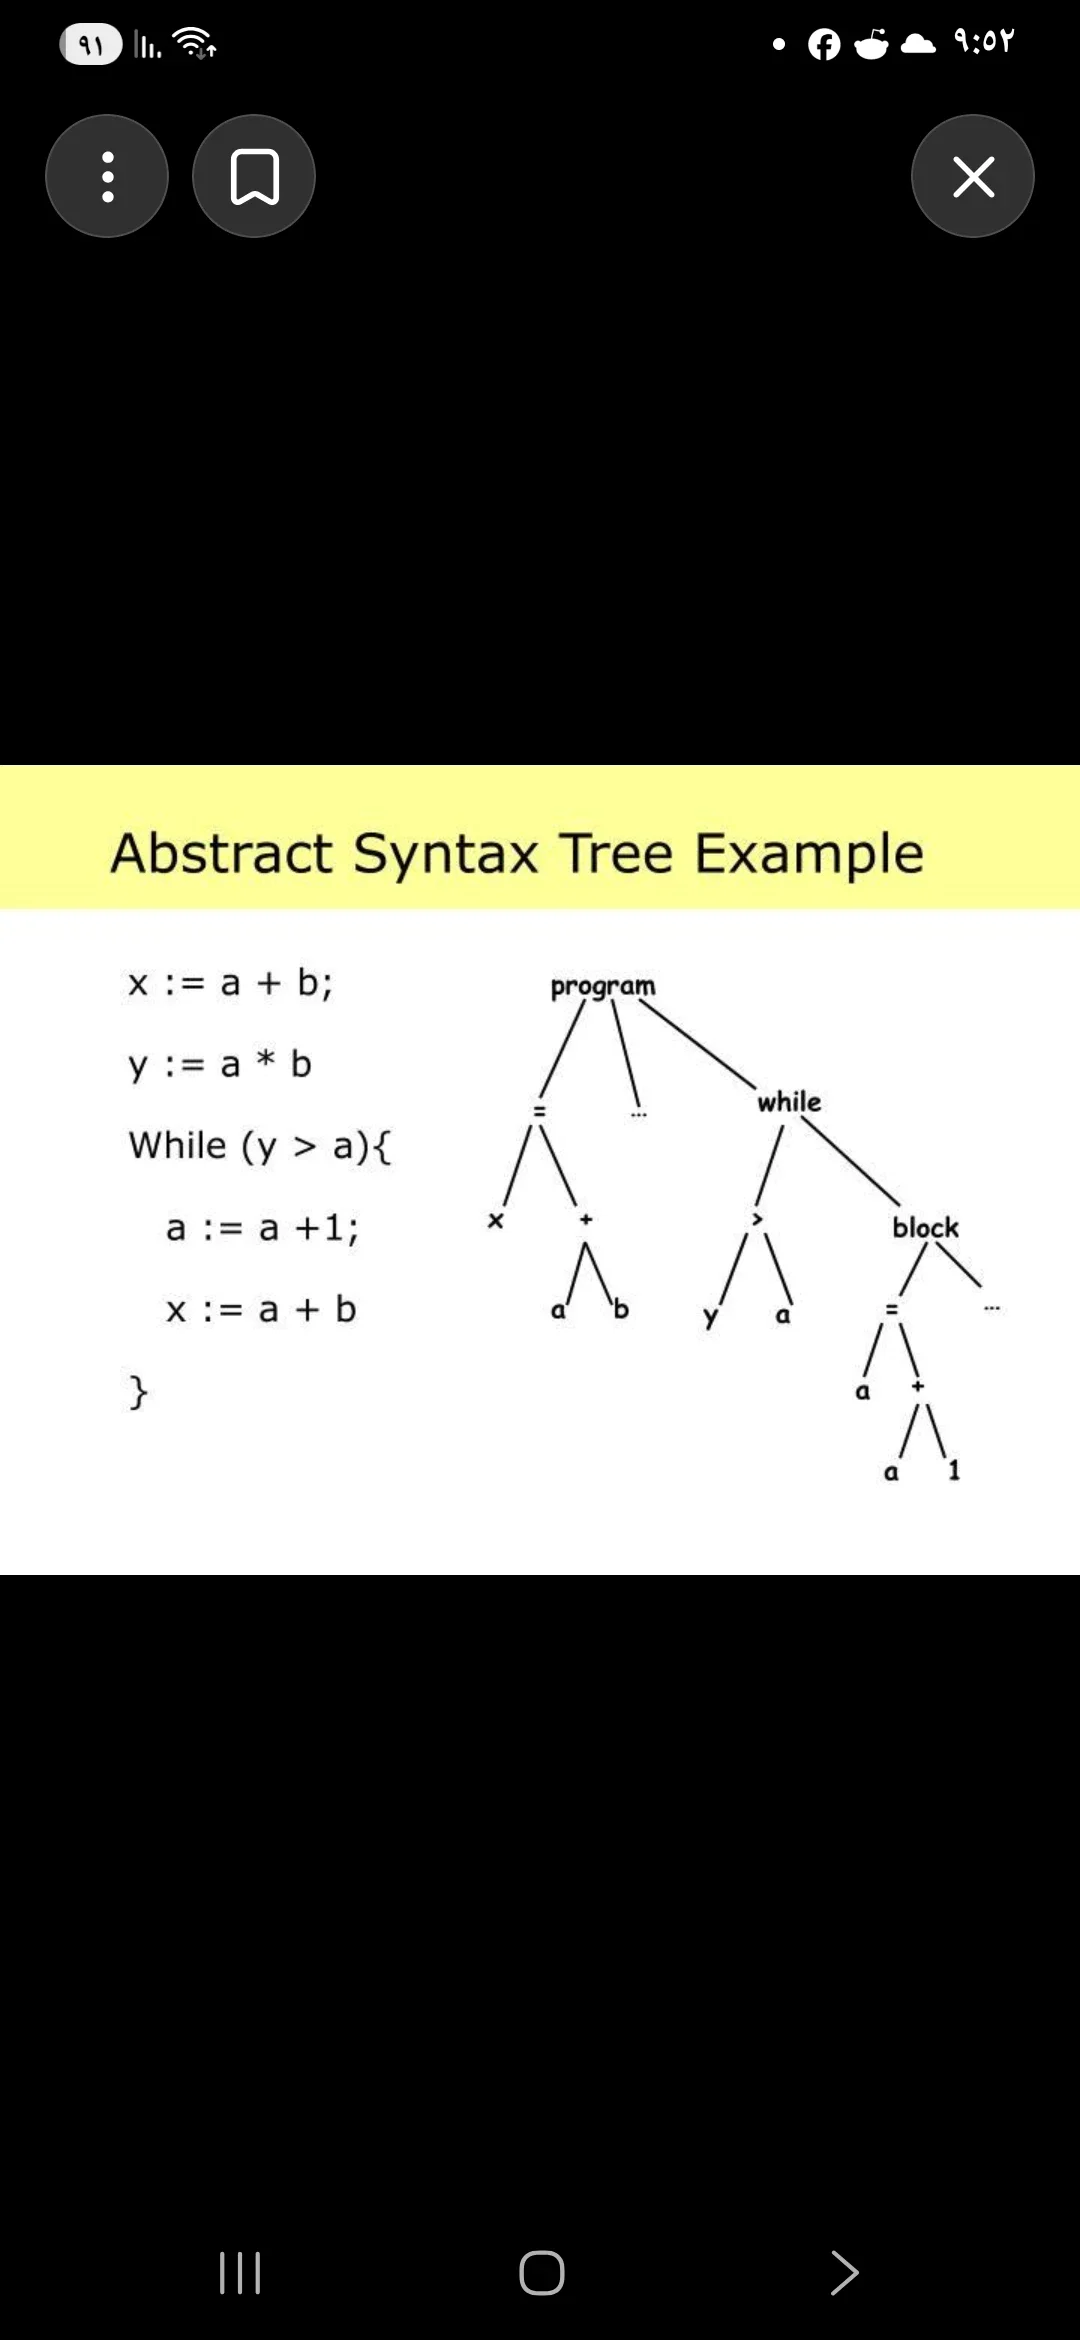
يعني المترجم مش بيبص للكود كسلسلة حروف وخلاص، لكنه بيحوّله إلى Structure يقدر يتعامل معاه.
وده مهم جدًا في المراحل اللي بعدها.
Semantic Analysis
ممكن يكون الكود صحيح نحويًا، لكن غلط من ناحية المعنى.
مثلًا:
int x;
x = "Hello";
من ناحية تركيب الجملة، مفيش مشكلة كبيرة في الـSyntax.
لكن عندنا مشكلة في الـType System.
"x" متغير من نوع "int"، بينما ""Hello"" عبارة عن String.
هنا بيبدأ Semantic Analysis.
المترجم بيفحص حاجات زي:
- أنواع المتغيرات.
- أنواع العمليات.
- هل المتغير اتعرّف قبل استخدامه؟
- هل الدالة موجودة؟
- هل عدد الـArguments صحيح؟
- هل أنواع الـArguments متوافقة؟
- نطاق المتغيرات Scope.
- قواعد التحويل بين الأنواع.
وهنا نبدأ نشوف إن تصميم لغة البرمجة نفسها موضوع مهم جدًا، لأن المترجم لازم يعرف بالضبط إيه المسموح وإيه الممنوع.
Symbol Table
خلال المراحل دي المترجم بيحتاج يحتفظ بمعلومات عن المتغيرات والدوال والأنواع.
وده بيتم عادة من خلال Symbol Table.
مثلًا لو عندنا:
int x;
float y;
المترجم محتاج يسجل إن:
x → int
y → float
وكمان ممكن يسجل معلومات عن الـScope، ومكان المتغير، والدوال، والـParameters وغيرها.
الـSymbol Table تعتبر جزء أساسي في تصميم معظم المترجمات.
Intermediate Representation
بعد ما المترجم يحلل البرنامج، ممكن يحوله إلى حاجة اسمها Intermediate Representation أو IR.
ودي من أهم الأفكار في تصميم المترجمات الحديثة.
ليه؟
لأنك لو عايز تعمل Compiler للغة معينة على خمس معماريات مختلفة، مش منطقي تعيد كل مراحل التحليل من البداية لكل Processor.
بدل كده، ممكن تعمل:
Source Code
↓
Lexer
↓
Parser
↓
Semantic Analysis
↓
Intermediate Representation
↓
├── x86
├── ARM
├── RISC-V
└── Other Targets
وبكده الـIR بتعمل كأنها طبقة وسيطة بين لغة البرمجة وبين الـHardware.
ومن أشهر الأمثلة على البنية دي LLVM.
Code Optimization
بعد تكوين الـIR، المترجم يقدر يبدأ مرحلة Optimization.
يعني يحاول ينتج كود أفضل من ناحية الأداء أو استهلاك الذاكرة أو حجم البرنامج، حسب الهدف.
مثلًا:
int x = 10 * 20;
المترجم ممكن يعرف إن الناتج ثابت ويساوي 200، فيقدر يحسب العملية أثناء الـCompilation بدل ما يسيب المعالج يحسبها وقت التشغيل.
وفي تحسينات تانية زي:
- Constant Folding
- Dead Code Elimination
- Loop Optimization
- Function Inlining
- Common Subexpression Elimination
- Register Allocation
طبعًا الموضوع مش سحر. المترجم عنده معلومات محددة، ومش بيقدر يتنبأ بكل حاجة هتحصل أثناء تشغيل البرنامج.
Code Generation
بعد كده نصل إلى مرحلة Code Generation.
هنا المترجم يبدأ يحول الـIntermediate Representation إلى تعليمات مناسبة للمعالج المستهدف.
لو الهدف هو x86-64، لازم المترجم يعرف تفاصيل معمارية x86-64.
ولو الهدف ARM، فالموضوع مختلف.
ولو الهدف RISC-V، عندنا Instruction Set مختلف.
وده يوضح العلاقة القوية بين Compiler Design وComputer Architecture.
المترجم لازم يعرف:
- Registers.
- Instructions.
- Memory addressing.
- Calling conventions.
- Stack.
- Function calls.
- Data representation.
وفي النهاية ينتج Assembly أو Object Code أو Machine Code حسب تصميم الـToolchain.
Linking
في لغات زي C وC++، الموضوع مش بيخلص عند الـCompiler.
ممكن يكون عندك:
main.c
math.c
device.c
وكل ملف بيتحول إلى Object File مستقل.
بعد كده ييجي دور Linker.
الـLinker بيربط الملفات ببعض، ويحل المراجع بين الدوال والمتغيرات، ويربط البرنامج بالمكتبات المطلوبة، وبعدها ينتج الـExecutable النهائي.
يعني الصورة الكاملة ممكن تكون:
Source Code
↓
Lexical Analysis
↓
Parsing
↓
Semantic Analysis
↓
AST
↓
Intermediate Representation
↓
Optimization
↓
Code Generation
↓
Assembly / Object Code
↓
Linking
↓
Executable
طيب إزاي نصمم لغة برمجة من الأساس؟
هنا بقى الموضوع بيبدأ من نقطة مختلفة.
قبل ما تعمل Compiler، لازم تحدد اللغة نفسها.
أول سؤال:
إحنا عايزين اللغة دي تعمل إيه؟
هل هي لغة للـEmbedded Systems؟
ولا للذكاء الاصطناعي؟
ولا للبرمجة العلمية؟
ولا لتطوير أنظمة التشغيل؟
ولا للـHigh Performance Computing؟
ولا لغة عامة General-Purpose؟
بعد تحديد الهدف، تبدأ تحدد الـSyntax.
مثلًا:
int x = 10;
ولا:
x : Integer = 10
ولا شكل مختلف تمامًا.
لكن الـSyntax مش كل حاجة.
لازم تحدد كمان Semantics.
يعني لو المبرمج كتب:
x = y + z
إيه بالضبط اللي المفروض يحصل؟
هل "x" لازم يكون من نفس النوع؟
هل اللغة تسمح بالـImplicit Conversion؟
هل المتغيرات Mutable ولا Immutable؟
إزاي الذاكرة بتتدار؟
هل فيه Garbage Collector؟
ولا Manual Memory Management؟
هل اللغة فيها Pointers؟
هل فيها Generics؟
هل فيها Object-Oriented Programming؟
هل فيها Functional Programming؟
هل فيها Concurrency وParallelism؟
كل دي قرارات تصميم.
تصميم نظام الأنواع
من أهم أجزاء تصميم اللغة Type System.
ممكن تعمل لغة Static Typed، بحيث يتم اكتشاف أنواع كثيرة من الأخطاء أثناء الـCompilation.
وممكن يكون عندك Dynamic Typing، بحيث يتم تحديد الأنواع أو التحقق منها أثناء التشغيل بدرجة أكبر.
وممكن تعمل نظام أكثر تعقيدًا يحتوي على Generics وTraits وType Inference وغيرها.
اختيار نظام الأنواع بيأثر بشكل مباشر على تصميم الـCompiler وعلى طريقة كتابة البرامج وعلى الأخطاء التي يمكن اكتشافها قبل تشغيل البرنامج.
إدارة الذاكرة
كمان لازم مصمم اللغة يقرر: مين مسؤول عن الذاكرة؟
في بعض اللغات، المبرمج بيتعامل مع الذاكرة بشكل مباشر.
في لغات أخرى، فيه Garbage Collector بيتولى اكتشاف الذاكرة التي لم تعد مستخدمة وتحريرها.
وفي لغات حديثة ظهرت أساليب مختلفة لإدارة الذاكرة، مثل نظام الملكية Ownership والـBorrowing.
وده يوضح إن تصميم اللغة مش مجرد اختيار شكل الأقواس والكلمات المحجوزة.
هو في الحقيقة تصميم نموذج كامل للتعامل مع الحاسوب.
Compiler أم Interpreter؟
فيه فرق مشهور بين الـCompiler والـInterpreter.
الـCompiler عادة بيحوّل البرنامج قبل التنفيذ إلى تمثيل آخر.
أما الـInterpreter فبيقوم بتفسير وتنفيذ البرنامج أثناء التشغيل.
لكن في الواقع الحديث، الحدود مش دايمًا حادة.
ممكن لغة تستخدم Bytecode، وبعدها Virtual Machine، وبعد فترة يتم تحويل أجزاء من البرنامج إلى Machine Code باستخدام JIT Compilation.
وده موجود في تقنيات مثل JVM.
يعني تصنيف اللغات إلى "Compiled" و"Interpreted" بشكل ثنائي بسيط مش دايمًا بيشرح الصورة الحقيقية.
علاقة لغات البرمجة بالـComputer Architecture
واحدة من أهم الحاجات في الموضوع كله إن لغة البرمجة في المستوى العالي بتخفي كمية ضخمة من التفاصيل عن المبرمج.
المبرمج يكتب:
x = a + b;
لكن في الخلفية لازم يحصل حاجات كثيرة:
المترجم يحدد أنواع البيانات، ومكان تخزينها، وإزاي يتم الوصول إليها، وإيه التعليمات المطلوبة للجمع، وهل القيم موجودة في Registers أو Memory، وإزاي يتم تمريرها إلى الدوال، وغيرها.
وبالتالي، تصميم المترجمات هو واحد من المجالات اللي بتوضح العلاقة بين Software وHardware بشكل مباشر جدًا.
الخلاصة
المترجم مش مجرد برنامج "بيحوّل لغة للغة"، لكنه سلسلة كاملة من مراحل التحليل والفهم والتحويل.
بيبدأ من النص اللي كتبه المبرمج، وبعدها يعمل Lexical Analysis، ثم Parsing، ثم Semantic Analysis، ويبني AST أو تمثيلًا مشابهًا، وبعدها يحول البرنامج إلى Intermediate Representation، ويطبق Optimization، ثم يولد Machine Code أو Object Code مناسب للمعمارية المستهدفة.
أما تصميم لغة البرمجة نفسها، فهو يبدأ بتحديد الهدف من اللغة، وبعدها تصميم الـSyntax والـSemantics ونظام الأنواع وإدارة الذاكرة ونموذج التنفيذ والتعامل مع التزامن والـHardware وغيرها.
وعشان كده دراسة Compiler Design مش مجرد دراسة طريقة تحويل "if" و"for" إلى تعليمات. هي دراسة للطبقة اللي بتربط بين الإنسان اللي بيكتب البرنامج وبين الآلة اللي هتنفذه.
وفي النهاية، السطر البسيط:
x = a + b;
وراه رحلة طويلة من الـTokens والـGrammar والـAST والـIR والـOptimization والـRegisters والـMachine Instructions.
الإنسان يكتب سطرًا واحدًا، والمترجم يقضي وقتًا طويلًا يفكر فيه بدلًا منه. واحدة من الحالات النادرة التي تستحق فيها الآلة هذا القدر من العمل.




النقاش
التعليقات (0)
فكرة تضيفها، أو سؤال يفتح حوارًا.
الرجاء تسجيل الدخول لتتمكن من التعليق